反应预测模型的浏览器部署与数值验证:ASKCOS / Pistachio
ASKCOS/Pistachio FP32 模型的浏览器移植:23 个输入的概率和搜索决策对照、两组预热任务的调度测量,以及保存结果复现方法。
Felix Fei
反应预测模型的浏览器部署与数值验证:ASKCOS / Pistachio
ASKCOS/Pistachio FP32 模型的浏览器移植:23 个输入的概率和搜索决策对照、两组预热任务的调度测量,以及保存结果复现方法。
2026-10-06 · Mol2Mat · Felix Fei · revision 1
摘要
本文以固定 Pistachio 检查点和原始 FP32 CPU 模型为参考,评估 ASKCOS Augmented Transformer 的浏览器实现。数值比较从逐步未归一化分数(logits)与概率延伸至候选排序和搜索决策;两组预热任务用于测量状态复用与调度优化的耗时变化。配套数据支持独立复核概率、决策与计时统计。
这里移植的是 ASKCOS Augmented Transformer 服务中基于 Pistachio 23Q3 数据训练的检查点,数值对照使用原始 FP32 CPU 模型。[1] 模型权重与服务修订共同确定运行版本。平台另有 CTranslate2 int8 配置,两者分别标识,便于追溯结果。
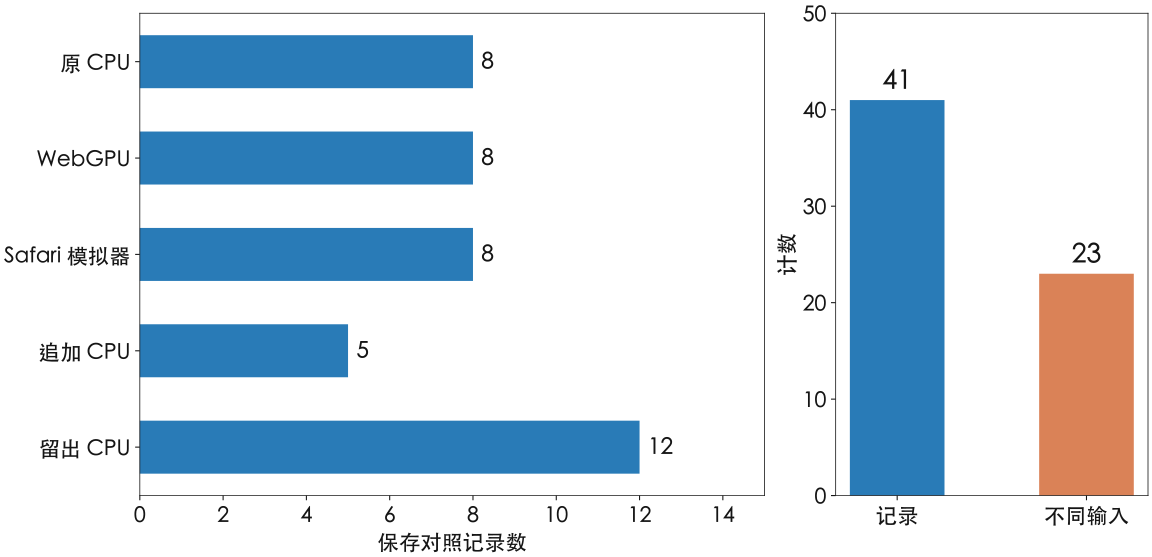
对照数据包含 23 个不同输入和 41 次浏览器运行,保存了各解码步的全词表 logits 与搜索决策。[4] 在此基础上,复用只读编码器状态可减少复制,调整任务调度可缩短等待。两个预热 Worker 测试的中位耗时分别降低 28.5 % 和 33.8 %,完整解码决策与优化前相同。[5]
化学表示、序列概率与搜索
RDKit 2026.03.6 解析输入并规范化异构 SMILES,保留立体化学、同位素和电荷。原子映射从分子对象中移除,反应物合并为点分隔混合物,再按固定词表分词;未知词沿用原 UNK 映射并生成警告。
模型自回归生成产物 token,beam search 保存五条路径,累计 token 对数概率决定排序:
原生与浏览器共同固定父束、token、并列排序、EOS 和最大长度规则。
候选分数在这一模型和搜索配置内用于排序。EOS 终止、最大长度终止、化学解析拒绝和最终接受分别记录。实验成功率与收率需由具有条件和真值的数据另行评价。
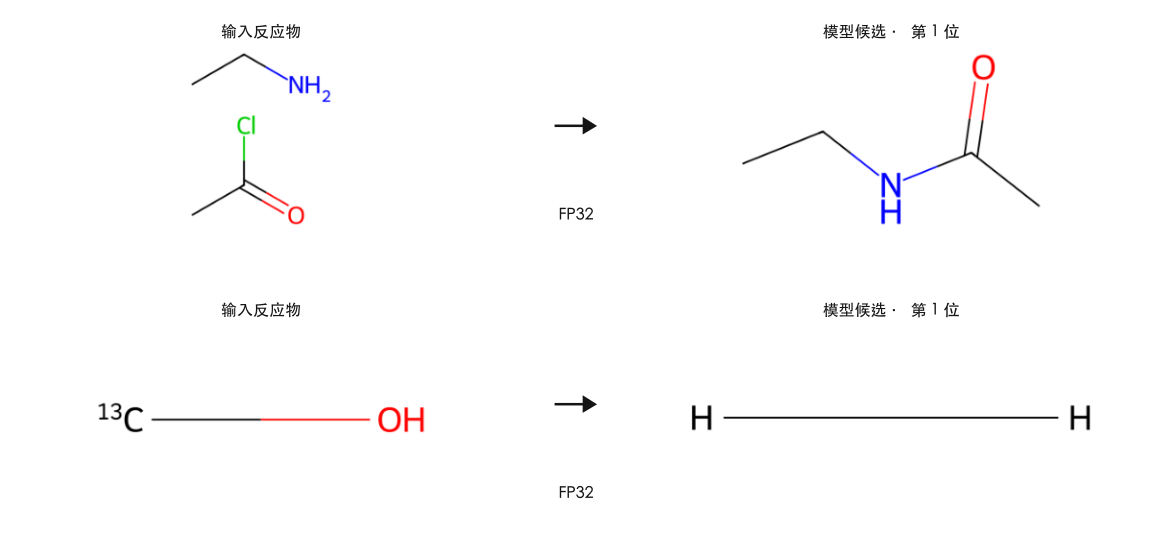
图 2 中两例直接取自保存输出:乙酰氯与乙胺输入的首位候选为酰胺;单独输入 [13CH3]OH 的首位候选为 H₂。两例均用于核查原模型与浏览器的输出一致性,化学解释集中于后文的候选评价。
模型与计算配置
原始检查点 SHA-256 为 0fdec0430d2890b54c12e9c3a6ad593db97a735a202b109e0d1454958adcadf2,服务修订固定为 897f5c39a7262d857f3239ee898b815338cf474 e。OpenNMT-py 1.2.0 模型包含 4 层编码器、4 层解码器、8 个注意力头、512 维隐藏表示及 2048 维前馈层。原生参考环境为 macOS Torch 2.5.1 CPU,供应方环境标识为 Torch 1.12.1 Linux/MKL。
推理使用原始 FP32 权重、固定词表与化学预处理条件。对照记录逐步输出及最终候选身份,并分别报告各执行后端的数值一致性。
默认浏览器路径为 ONNX Runtime Web 1.30.0 的单线程 WASM CPU,化学处理使用独立 RDKit WASM。[3] WebGPU 的覆盖为原八例;追加与留出输入采用 CPU 路径。各后端的证据与配置分别记录。
模型、词表、图、运行时和 Worker 通过哈希绑定到执行配置。任务管理提供取消、回执与持久化,缓存候选保留模型身份,使不同执行配置的结果可追溯。
原生模型与浏览器的逐层对照
从原始 FP32 Torch 到原生 ONNX Runtime,再到浏览器,三套输出让误差发生的位置可以逐层检查。比较内容包括编码器表示、每个保存步的全词表 logits、self / 交叉注意力 缓冲,以及父束、token 路径、EOS、候选顺序和累计分数。原八例的一份比较含 81903288 个标量。[4]
23 个不同输入覆盖单一物种、多组分、芳香卤化物、盐、原子映射、手性、同位素、酰化、杂芳环、E/Z 和缺少条件的控制。41 次记录由原 CPU 八例、WebGPU 八例、Safari 模拟器八例、追加 CPU 五例和留出 CPU 十二例组成。
十二个留出输入在版本化验证规则确定后计算,并保存独立 Torch 与原生 ONNX 完整解码。四个构造控制检查并列、近并列、EOS 和最大长度。这一语料专用于移植与搜索边界验证;实验准确率基准需另行确定实验真值、分割与匹配规则。
| 执行集合 | 记录数 | 输入范围 |
|---|---|---|
| original-cpu | 8 | 原始或追加 CPU 探针 |
| original-gpu | 8 | 原八例重复后端 |
| original-safari-simulator | 8 | 原八例重复后端 |
| additional-cpu | 5 | 原始或追加 CPU 探针 |
| new-holdout-cpu | 12 | 新增留出输入 |
| 合计 | 41 | 23 个不同输入 |
从 logits 差异检查搜索决策
原逐元素规则为 。同位素输入在旧 CPU 报告的解码步 9、12、13(从 0 计数)出现三个 logits 超限;WebGPU 有五个超限,原生 ONNX 存在对应差异,Safari 模拟器 CPU 缓冲与桌面 CPU 相同。这些原始记录与后续评估并列提供。
| 字段 | 验收规则 | 保存结果 |
|---|---|---|
| 编码器与全部 cache | atol 1×10⁻⁵; rtol 1×10⁻⁴ | 全部满足 |
| 完整词表概率差 | ≤ 1×10⁻⁵ | 3.3768861 × 10⁻⁶ |
| 行总变差 | ≤ 1×10⁻⁵ | 3.4359221 × 10⁻⁶ |
| 路径、token、EOS、结构与排序 | 精确一致 | 41 次记录一致 |
| 旧同位素 logits 超限 | 旧判据原样保留 | CPU 3;WebGPU 5 |
Softmax 将 logits 转为概率:
行常数偏移在 Softmax 下抵消,因此原始 logits 差与决策概率差分别检查。
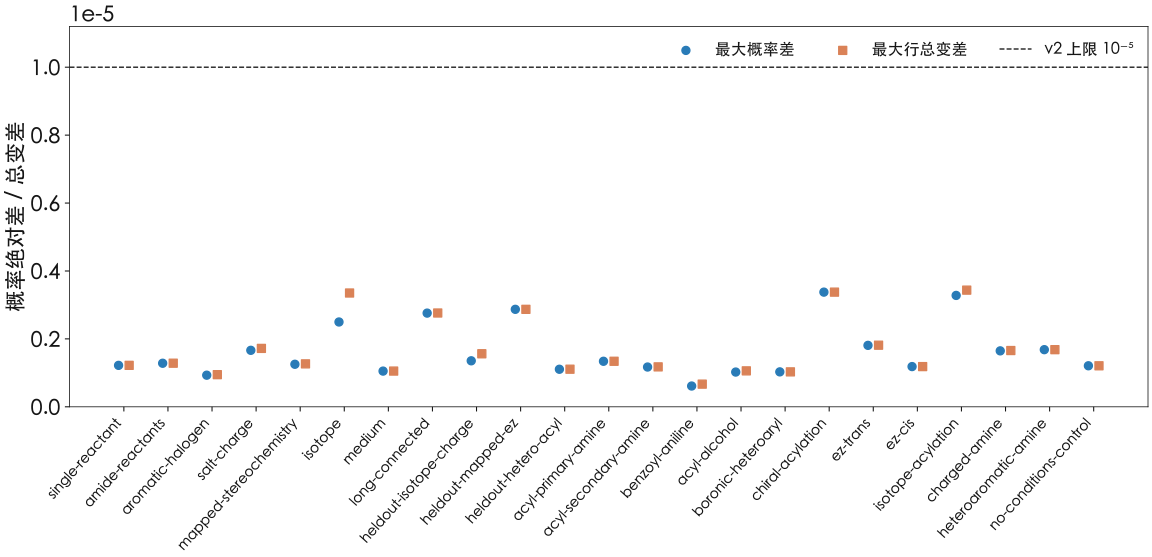
为检查这些差异是否改变搜索,v2 在原编码器及缓存容差之外,要求全词表概率最大差与行总变差均 ≤10⁻⁵。BOS 时的 EOS 屏蔽、已访问 beam 路径、最终 token、EOS、候选结构及排序也须相同,累计分数沿用原容差。这样既保留逐元素差异的记录,也直接检查概率和搜索决策。
41 次记录的最大概率差为 3.3769×10⁻⁶,最大行总变差为 3.4359×10⁻⁶,均满足 v2 判据,已访问路径的搜索决策一致。该结论对应全部保存步的全词表概率和实际访问 beam;候选接近并列时,逐步概率与离散排序共同决定一致性判定。
结构有效性与预测准确率的区别
RDKit 对 23 个输入的 66 个接受候选执行结构和身份核查,并以 148 个边界夹具检查解析与预处理。记录包括结构消毒、规范异构 SMILES、分子式和元素/同位素信息;这些字段用于追踪输入处理和候选身份。反应预测的化学评价以给定条件下的实验产物为参照。[4]
保存输出包含以下模型行为:同位素甲醇单输入的首位候选为 H₂,手性乳酸输入可产生立体化学未指定的候选,酰化候选包含多种结构变化;[Cl-] 可触发固定词表的 UNK 警告。原始候选与警告随结构图和数值记录保存,用于逐例分析。
模型输入为反应物序列。化学预测评价采用具有溶剂、催化剂、温度等条件记录的独立实验数据,固定训练/测试分割、去重和产物匹配规则,并据此计算 top-k 准确率。本文的概率与搜索比较评价固定模型在不同运行时的数值行为。
配对性能实验
预热任务在相同模型、输入、进度数量与完整搜索输出下进行配对测量。计时涵盖任务提交至结果返回,初始化范围与重复次数分别记录。
只读编码器状态与 beam 重排
beam search 在每步选择父路径并重排状态。编码器 memory 与 交叉注意力 K/V 由当前反应物输入决定,首次扩展后的五行相同,可共享只读状态。自注意力 K/V 保存各路径已生成的 token 历史,随父束 执行重排。
| 输入 | 原复制 / bytes | 新复制 / bytes | 减少 |
|---|---|---|---|
| acyl-primary-amine | 14643200 | 5519360 | 62.3 % |
| chiral-acylation | 47185920 | 15851520 | 66.4 % |
设 为编码器状态, 为交叉注意力状态, 为束 的自注意力历史。在单输入、同一编码器上下文中:
首次扩展到束宽后, 与 保持只读,仅对 按索引聚集(gather)。多输入批次 则需要按上下文身份管理各行状态。
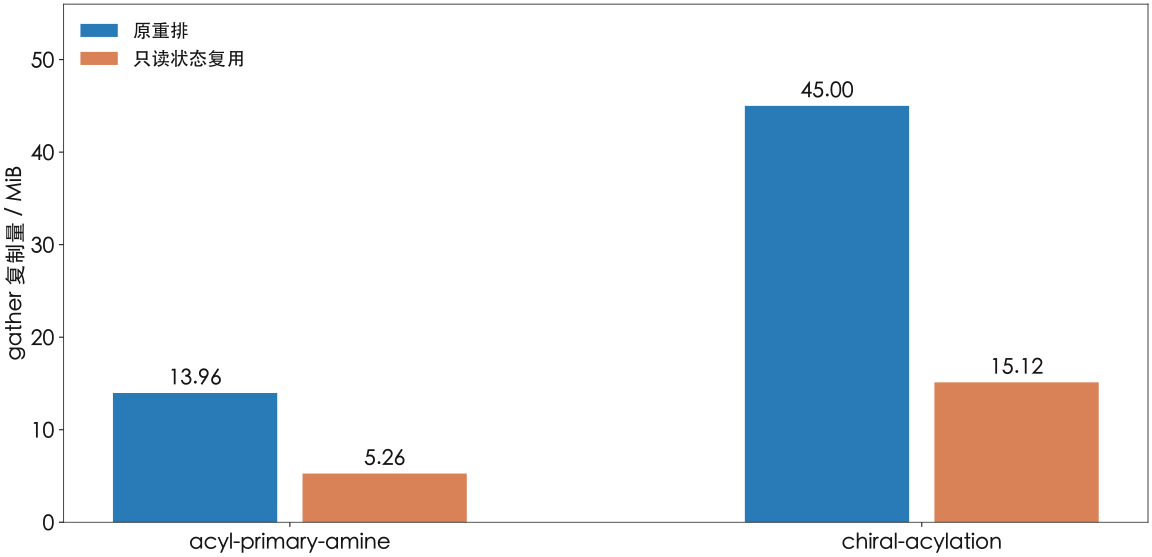
按 gather 调用累加复制字节,两例分别从 14643200 降至 5519360 字节、从 47185920 降至 15851520 字节,减少 62.3 % 与 66.4 %。完整 beam trace、EOS、候选和分数相同,FP32 权重、排序与终止规则也沿用原定义。这个实验测得的是复制量;隔离的模型计时未显示稳定改善,总任务耗时则由下一节的 Worker 配对测量给出。[5]
两组反应输入的配对耗时
同一 macOS Chromium 会话交替执行旧、新分发包,各预热一次后测三次。acyl-primary-amine 中位耗时从 115.0 降至 82.2 ms,降低 28.5 %;chiral-acylation 从 223.7 降至 148.0 ms,降低 33.8 %。图 5 中同时展示中位数和每次实测。[5]
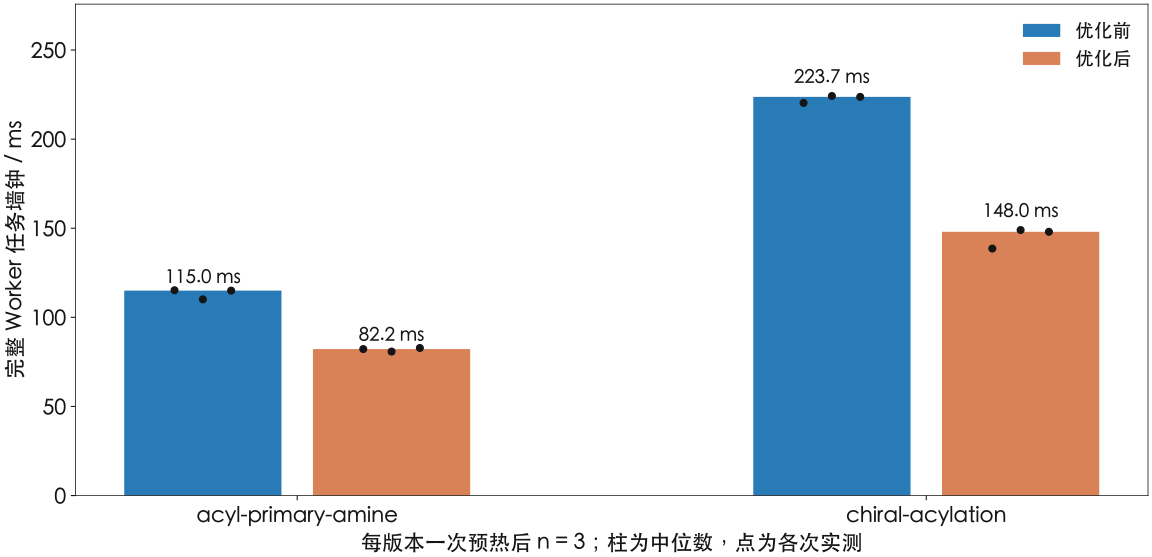
| 输入 | 优化前 / ms | 优化后 / ms | 耗时降低 |
|---|---|---|---|
| acyl-primary-amine | 115.0 | 82.2 | 28.5 % |
| chiral-acylation | 223.7 | 148.0 | 33.8 % |
计时覆盖任务协议、进度、模型计算与结果回传。两例分别保留 11 和 19 次进度事件,完整 beam trace、EOS、候选及分数逐项相同。主要时间收益来自减少反复调度等待,只读状态复用则减少单独记账的复制工作。
优化后的分发包通过 17 项 broker / Worker 数值和生命周期检查,取消约 14.7 ms 后重试成功,数值资产哈希也相同。配对计时显示任务更快;23 个输入的 v2 对照检查概率和决策,而原始 logits 超限记录仍随数据提供。
测量范围为这两个解码长度下的预热 CPU WASM 任务,每版本 ,电脑同时承担其他工作。解码长度、attention 状态增长和 beam 终止共同影响成本,进一步的性能比较应保持相同初始化与计时边界。
首次装载与重复推理
FP32 模型与运行时资源约 155.9 MiB,首次装载后按哈希缓存。后续查询复用这些资源,因此首次准备与重复推理的耗时分别记录。
原 CPU 八例的单次墙钟约为 0.0965–0.8026 s,运行时准备约 0.4346 s。这组 探针包含数值取样和检查。WebGPU 与 CPU 各自的准备与取样开销分别记录,受控性能比较采用前述同边界 Worker 配对。
探针记录 ONNX WASM 线性内存 290717696 字节,RDKit 16777216 字节。任务采用 120 s 墙钟限制与 1.5 GiB 准入估算;进程 RSS 是另一个测量指标。输入限于 8 个反应物、100 个重原子、512 字符和 256 个源 token。
Safari 模拟器提供原八例的运行与数值证据。物理手机的 CPU、内存与热状态需要设备测量。离线本地执行依赖所需模型、运行时及词表已完整缓存。
| 输入 | 带检查探针 / s |
|---|---|
| single-reactant | 0.1633 |
| amide-reactants | 0.1457 |
| aromatic-halogen | 0.1235 |
| salt-charge | 0.0965 |
| mapped-stereochemistry | 0.1620 |
| isotope | 0.1924 |
| 中 | 0.2660 |
| long-connected | 0.8026 |
数据与复现方法
公开附件可复现保存解码路径的概率与决策比较。visited-logits.npz 和 logit-pairs.json 提供 logits 及其配对身份;按本文稳定 Softmax 公式逐行计算概率,重算最大绝对差与总变差,再核对父束、token、EOS 和候选顺序。raw-results.json.gzip、summary.csv 与 evidence.json 保留原始判据、超限记录及 v2 评估来源。
optimization.json 与 optimization.csv 可用于按原预热排除规则重算配对中位数和耗时降幅。完整编码器及 attention 缓冲、导出程序和核查程序保存在项目归档中。重新进行模型推理需准备固定检查点、词表、RDKit 预处理及所列运行时,按依赖许可获取材料,并分别记录数值比较与运行时间。[1, 5]
Data and sources
- Raw numerical results and native references · JSON gzip
- Numerical summary · CSV
- Provenance and verification records · JSON
- All saved-step logits · NPZ
- Native and browser decision records · JSON
- Optimization pairs, builds and cancellation · JSON
- All optimization timings including warmup · CSV
- State copy volume · CSV
- ASKCOS Augmented Transformer: upstream service and model provenance
- I. V. Tetko et al. State-of-the-art augmented NLP transformer models for direct and single-step retrosynthesis. Nature Communications 11, 5575 (2020). doi:10.1038/s41467-020-19266-y
- ONNX Runtime: browser execution providers and Web deployment
- Mol2Mat: preserved raw gates, v2 policy, holdouts and archive identities
- Mol2Mat: paired real-Worker scheduling and state-reuse measurements, 2026-10-10